مدل جمنای ۴ کربن در تازهترین ارزیابی مدلهای مرزی نتوانست صدر جدول را تصاحب کند، اما ترکیب عملکرد نزدیک به رهبر بازار و هزینهی بسیار پایینتر، جایگاه متفاوتی برای مدل تازهی گوگل ساخته است. نتایج نشان میدهند رقابت مدلهای هوش مصنوعی دیگر تنها بر سر بیشترین امتیاز نیست و هزینهی انجام کار نیز به معیاری تعیینکننده تبدیل شده است.
معیار GDPx مدلهای مرزی بزرگ گوگل، اوپنایآی، آنتروپیک و متا را بر اساس امتیاز و هزینهی اجرای هر وظیفه کنار یکدیگر قرار میدهد.
GDPx از ۲۰۶ وظیفه در مجموعهای گسترده از حوزههای حرفهای تشکیل شده است. امور مالی، علم مواد، امنیت سایبری، مهندسی نرمافزار، حقوق و زیستشناسی بخشی از موضوعات آزمون را پوشش میدهند. گستردگی وظایف باعث میشود نتیجه صرفا بازتاب توانایی مدل در تولید متن عمومی یا پاسخگویی به پرسشهای رایج نباشد.
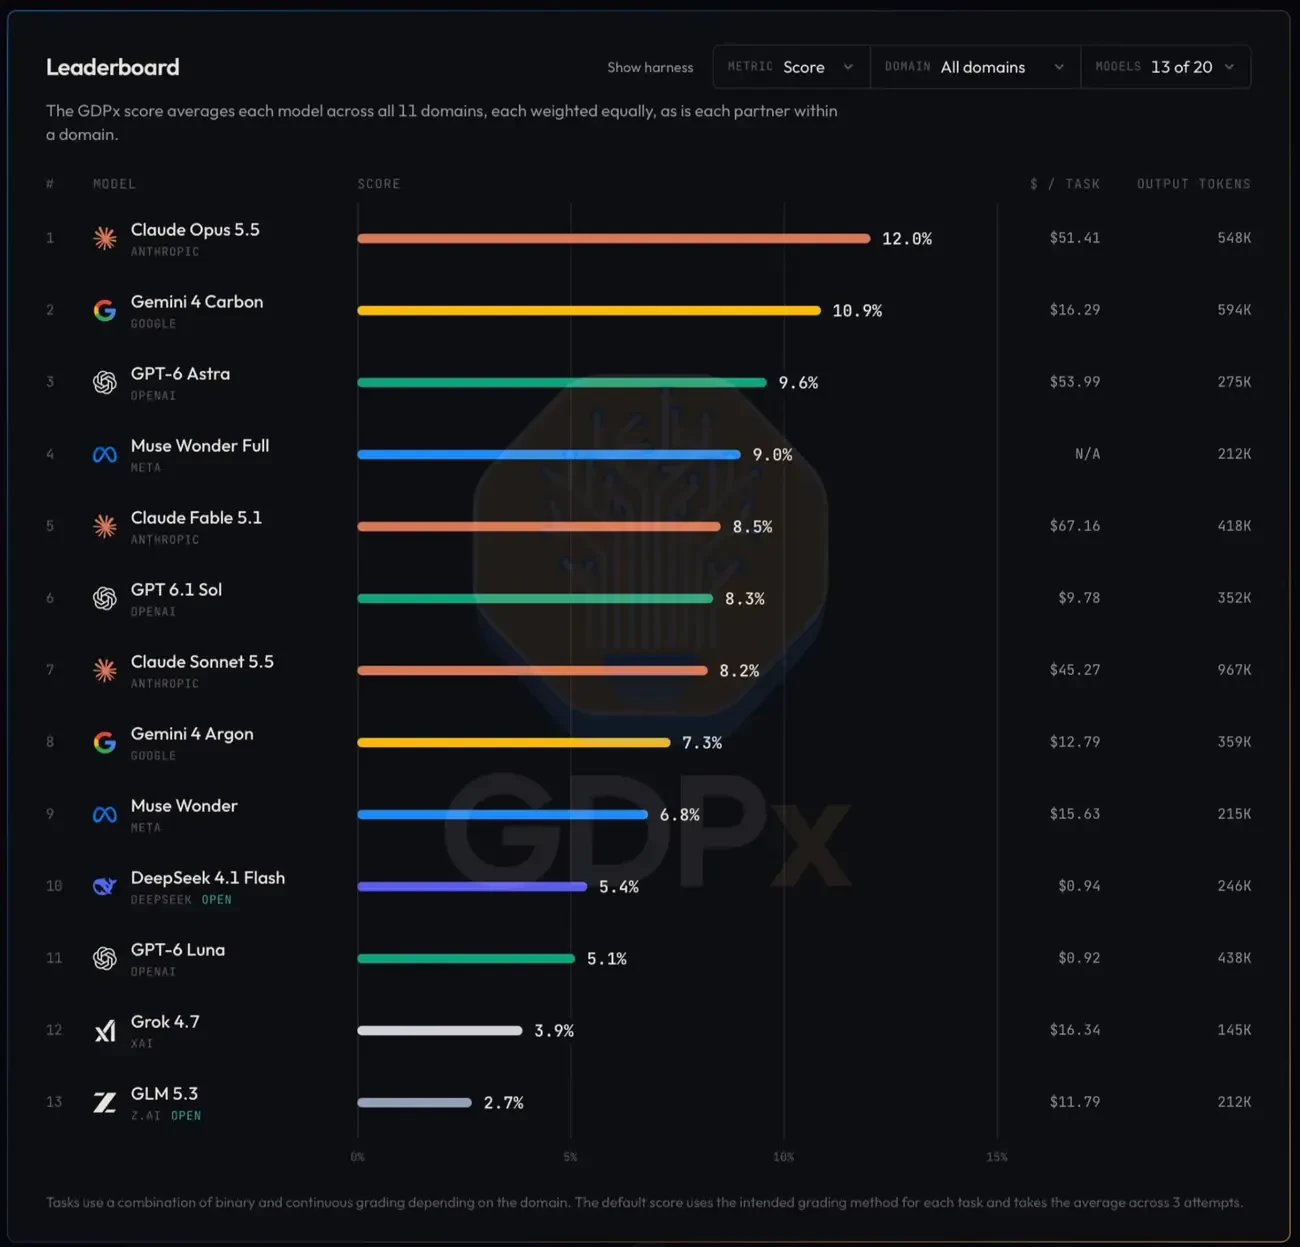
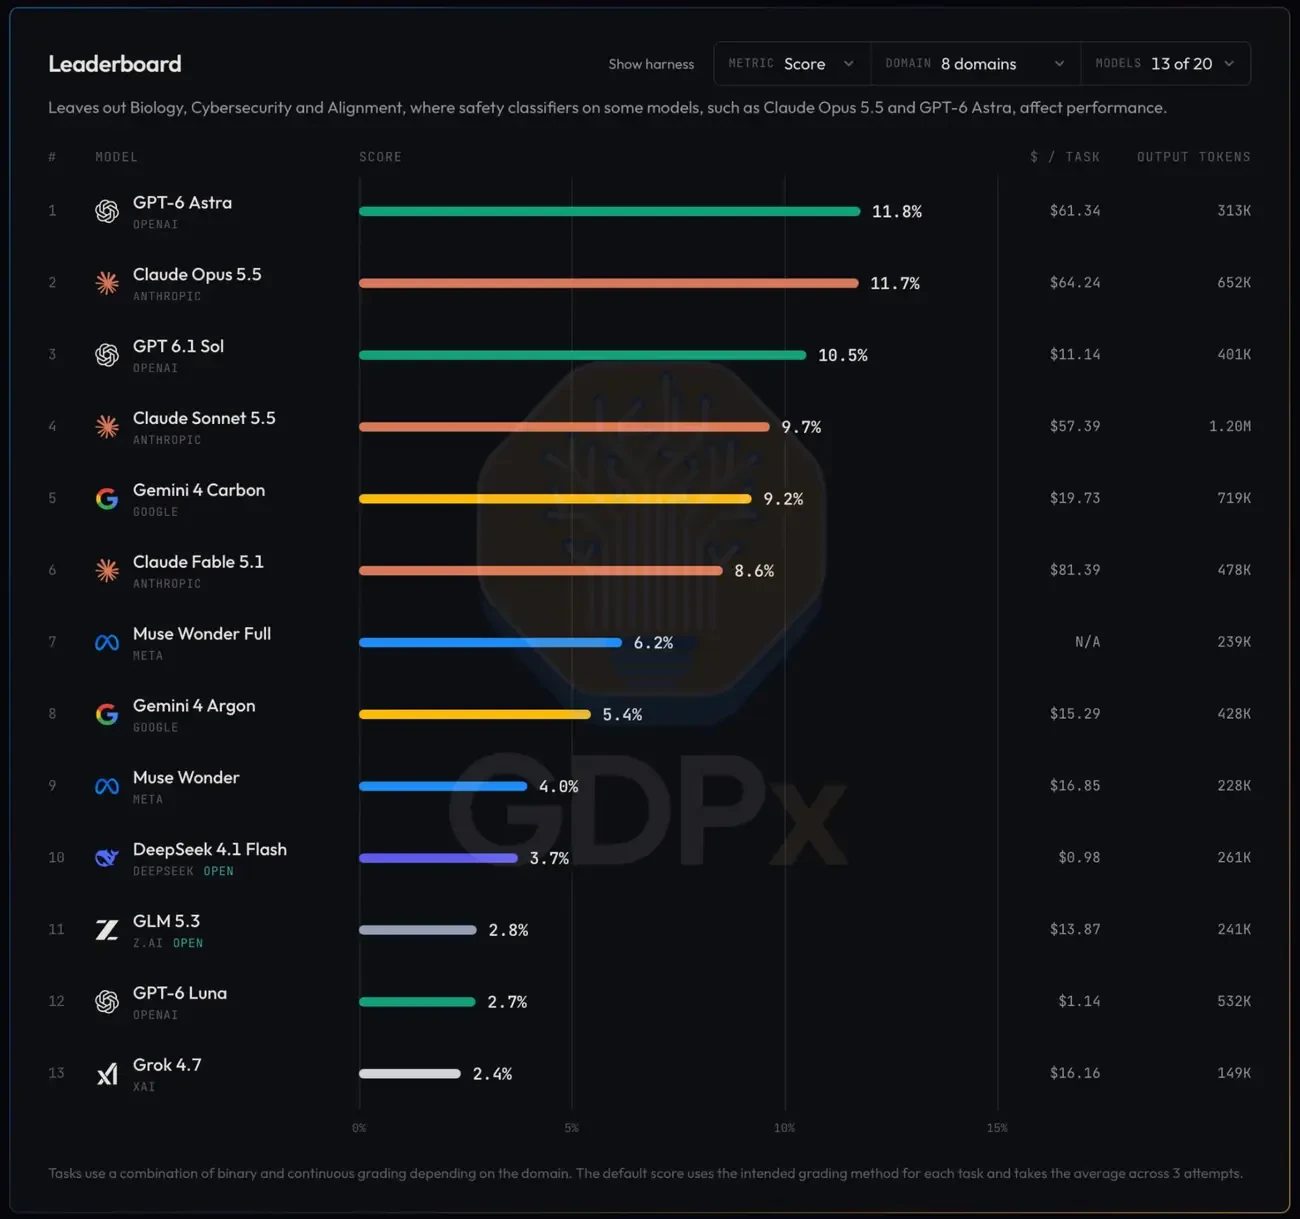
صدر جدول به کلاد اپوس ۵٫۵ از آنتروپیک رسید و جمنای ۴ کربن با فاصلهای نسبتا محدود پشت سر آن قرار گرفت. اختلاف امتیاز دو مدل اندک توصیف شده، اما شکاف هزینه بسیار بزرگتر بود. اجرای هر وظیفه با کلاد حدود ۵۱ دلار هزینه داشت، درحالیکه هزینهی جمنای ۴ کربن کمی بیش از ۱۶ دلار برای هر وظیفه محاسبه شد.
بنابراین هزینهی مدل گوگل به کمتر از یکسوم رقیب صدرنشین میرسد. چنین اختلافی در استفادههای پرتعداد، آزمایشهای تکرارشونده و سامانههای سازمانی میتواند اثر مالی قابلتوجهی داشته باشد، حتی اگر کلاد همچنان امتیاز نهایی بالاتری ثبت کرده باشد.
مدل GPT-6 Astra رتبهی بعدی جدول را به دست آورد، ولی هم امتیاز پایینتری از جمنای ۴ کربن ثبت کرد و هم هزینهی بیشتری روی دست کاربران گذاشت. میانگین هزینهی اجرای هر وظیفه با مدل اوپنایآی حدود ۵۴ دلار گزارش شد که از هر دو مدل اپوس ۵٫۵ و جمنای ۴ کربن بالاتر بود.
مقایسهی سه مدل، تفاوت میان رهبر عملکرد و رهبر ارزش اقتصادی را روشن میکند. اپوس ۵٫۵ بیشترین امتیاز کلی را دارد، جمنای ۴ کربن با هزینهای بهمراتب کمتر به آن نزدیک شده و GPT-6 Astra با وجود هزینهی بالاتر، پایینتر از هر دو قرار گرفته است.
کپی لینکحذف چند حوزه، چگونه رتبهبندی را تغییر داد؟
SemiAnalysis نسخهی دیگری از رتبهبندی را نیز منتشر کرد که وظایف امنیت سایبری، زیستشناسی و همترازی هوش مصنوعی در آن کنار گذاشته شده بودند. حذف سه حوزه، آرایش مدلهای بالای جدول را تغییر داد و GPT-6 Astra را به رتبهی نخست رساند.
در رتبهبندی تعدیلشده، GPT 6.1 Sol و اپوس ۵٫۵ نیز بالاتر از جمنای ۴ کربن ایستادند. پژوهشگران SemiAnalysis گفتهاند نتیجهی دوم با برداشتهای ذهنی آنان از توانایی مدلها هماهنگی بیشتری دارد.
گزارش، محدودیتهای ایمنی کلاد و مدلهای GPT را یکی از عوامل موثر بر جابهجایی نتایج میداند. محافظهای ایمنی ممکن است مدل را از تکمیل بعضی وظایف امنیت سایبری، زیستی یا مرتبط با همترازی بازدارند. درنتیجه، امتیاز خام همیشه فقط توان فنی مدل را اندازه نمیگیرد و گاهی میزان آمادگی آن برای پاسخگویی به درخواستهای حساس را نیز بازتاب میدهد.
مدل مرزی قبلی گوگل با نام جمنای ۴ آرگون در هر دو نسخهی رتبهبندی جایگاه هشتم را کسب کرده بود. آرگون بالاتر از Muse Wonder متعلق به متا و پایینتر از Wonder Full قرار گرفت.
هزینهی آرگون در آزمون GDPx تنها اندکی پایینتر از جمنای ۴ کربن بود. فاصلهی محدود هزینه، همراه با جایگاه بهتر کربن، نشان میدهد مدل تازهی گوگل نسبت به آرگون بهبود محسوسی در نسبت امتیاز به هزینه ارائه میکند.
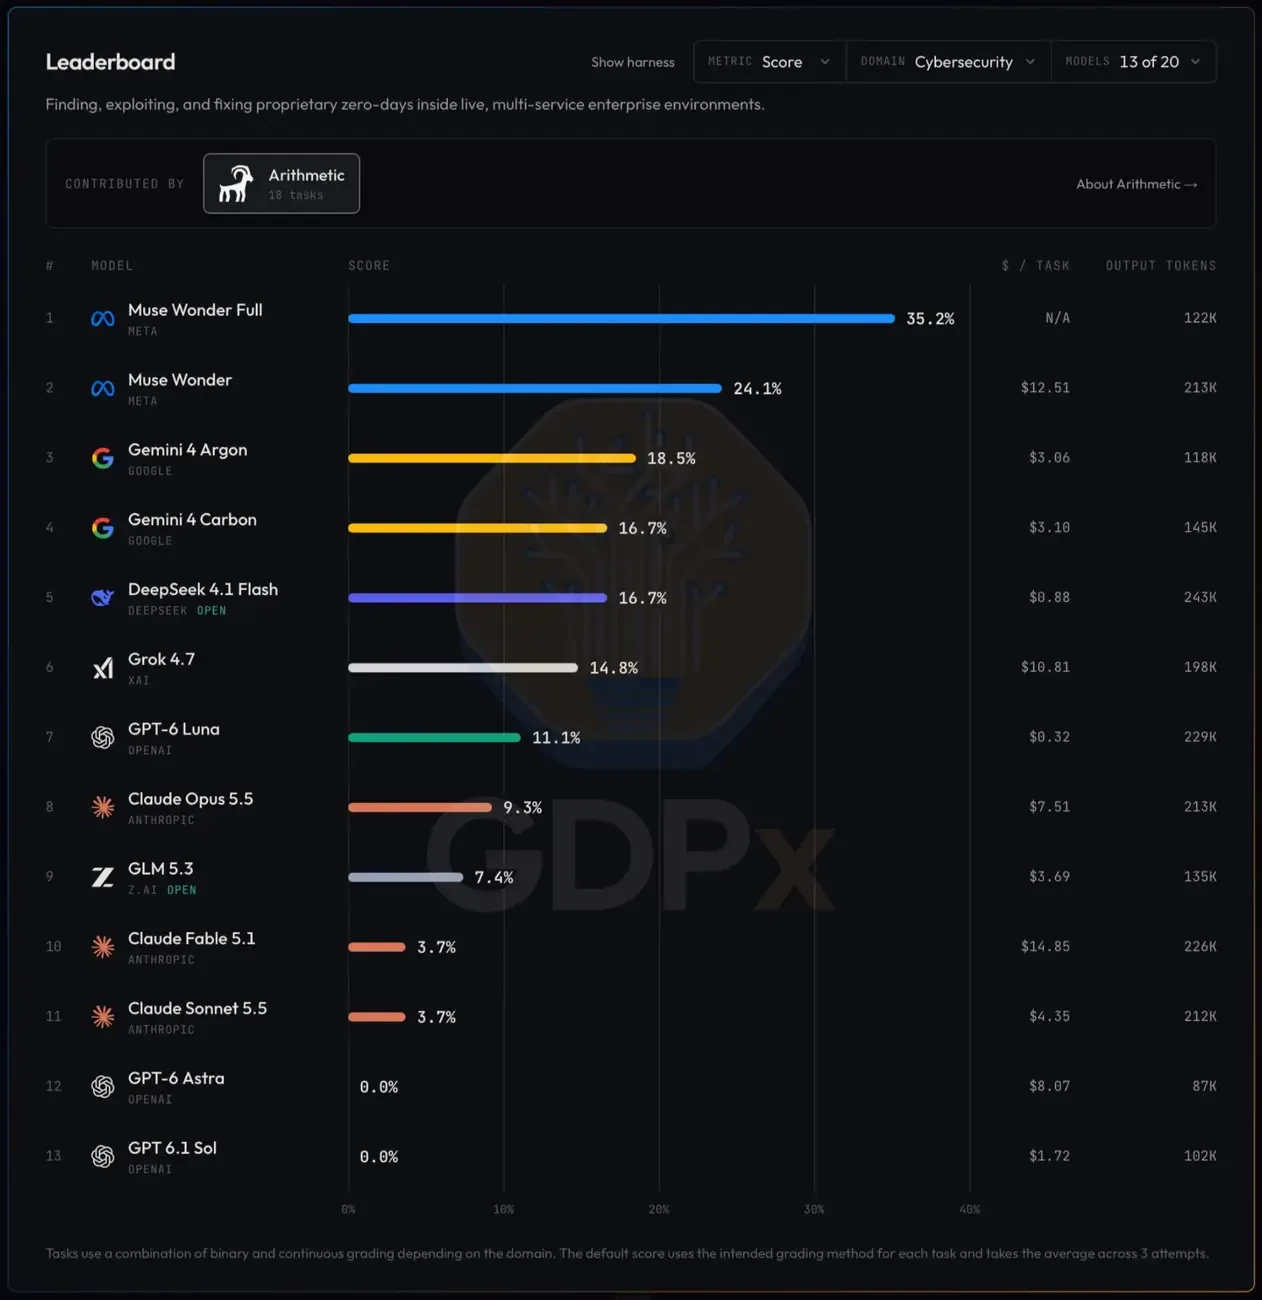
تمرکز صرف بر امنیت سایبری تصویر دیگری میسازد. هر دو مدل گوگل در وظایف مرتبط با امنیت سایبری از مدلهای اوپنایآی و آنتروپیک امتیاز بیشتری گرفتند، اما از خانوادهی Muse متعلق به متا عقب ماندند. طبق یافتهی معیار GDPx، مدلهای Muse در حوزهی امنیت سایبری با فاصلهای معنادار بهترین عملکرد را ثبت کردهاند.
بهنظر شما عملکرد بهتر مهمتر است یا هزینهی کمتر؟ دیدگاهتان را بنویسید.