تصور کنید ربع قرن پیش قاعدهای دربارهی محدودیت کامپیوترها پیشنهاد دادهاید. همکارانتان آن را پذیرفتهاند، صدها مقاله براساسش نوشتهاند و هیچکس هم نتوانسته خلافش را ثابت کند. حالا یک روز خبر میرسد که مدلهای هوش مصنوعی قاعدهی شما را از اساس رد کردهاند و از شما میخواهند داور همین ادعا باشید.
راسل ایمپالیاجو و راماموهان پاتوری، دو استاد علوم کامپیوتر دانشگاه کالیفرنیا در سندیگو، امروز دقیقا در چنین موقعیتی قرار دارند. OpenAI روز ۲۶ اکتبر ۲۰۲۶ اعلام کرد یکی از مدلهای داخلیاش «فرضیهی زمان نمایی» یا ETH را رد کرده است؛ فرضیهای که همین دو دانشمند بههمراه فرانسیس زین ارائه داده بودند. به گفتهی شرکت، مدل هوش مصنوعی، برهان را ۱۶ اکتبر پیدا کرد و یک روز بعد، استدلال آن در سامانهی اثبات رسمی Lean بازنویسی و بهشکل ماشینی بررسی شد.
یکی از ابزارهای اصلی برهان را قضیهای بهنام «لم پراکندهسازی» میدانند؛ قضیهای که خود ایمپالیاجو، پاتوری و زین در سال ۲۰۰۱ برای تقویت مبانی فرضیهشان ارائه کرده بودند. حالا ۲۵ سال بعد، همان ابزار در برهانی بهکار رفته است که فرضیهی آنها را رد میکند. درواقع پژوهشگران برای رد فرضیهی ETH از یکی از دستاوردهای علمی سازندگان خودش استفاده کردهاند.
حتی اگر صحت ادعای اوپنایآی تایید شود، فردا صبح هیچ کامپیوتری سریعتر کار نمیکند، هیچ رمزی نمیشکند و هیچ اپلیکیشنی تغییر نمیکند. پس چرا دنیای علوم کامپیوتر با شنیدن خبر اینقدر هیجانزده شد؟ برای درک اهمیت فرضیهی زمانی نمایی، باید سراغ یکی از سادهترین و درعینحال سرسختترین معماهای محاسبات برویم.
کپی لینکمعمای کلیدهای روشن و خاموش
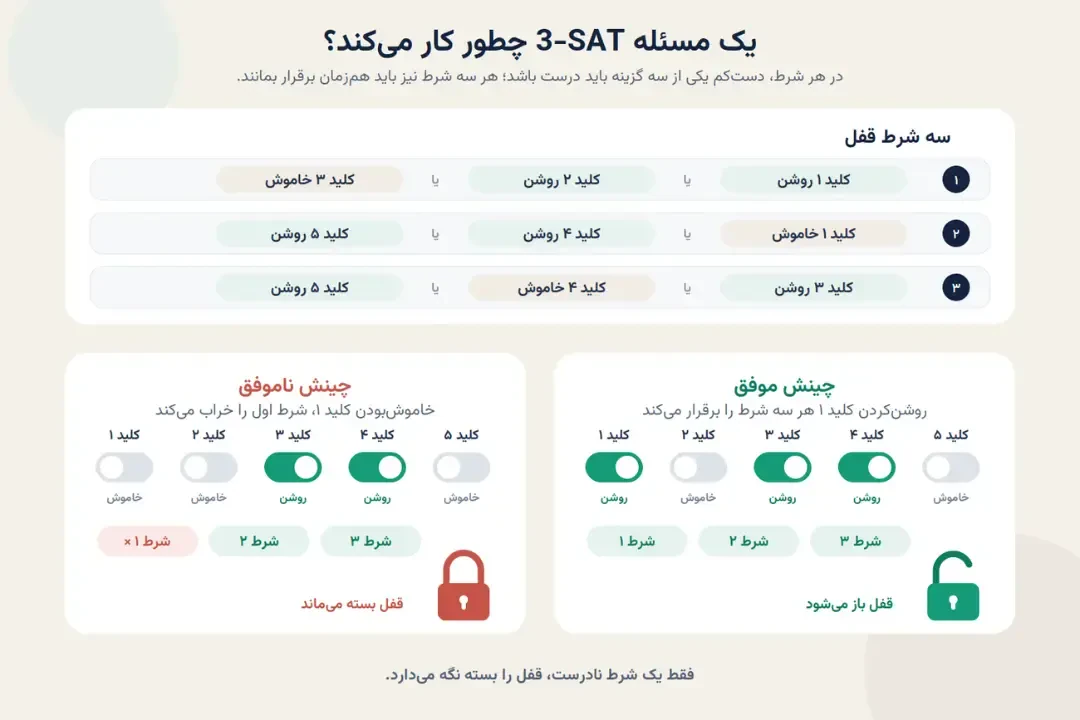
فرض کنید پشت ردیفی از کلیدهای برق نشستهاید و هر کلید فقط میتواند روشن باشد یا خاموش، حالت میانهای در کار نیست. فهرستی از شرطها را هم به دستتان دادهاند و هر شرط سه کلید را نام میبرد؛ مثلا «یا A روشن باشد، یا B خاموش، یا C روشن»، یا «یا کلید اول خاموش باشد، یا کلید چهارم یا پنجم روشن باشد.»
برای برآوردهشدن هر شرط، کافی است دستکم یکی از سه گزینهی آن درست باشد؛ اما آیا میتوان کلیدها را طوری تنظیم کرد که تمام شرطها همزمان برقرار شوند؟ دانشمندان علوم کامپیوتر این معما را «3-SAT» مینامند. در زبان منطق، هر کلید یک متغیر به شمار میرود که فقط دو حالت دارد؛ درست یا نادرست.
مسئلهی 3-SAT شاید در نگاه اول شبیه بازیهای فکری بهنظر برسد؛ اما یکی از مشهورترین مسائل «NP-کامل» در علوم کامپیوتر محسوب میشود. اگر کسی روشی واقعا سریع برای حلش پیدا کند، هزاران مسئلهی بسیار سخت دیگر، از زمانبندی پروازها تا طراحی تراشه، با همان روش حل میشوند.
دشواری مسئله به تعداد حالتهای ممکن برمیگردد. با اضافهشدن هر کلید، تعداد چیدمانها دو برابر میشود؛ برای مثال ده کلید، ۱۰۲۴ حالت مختلف دارند، چهل کلید بیش از هزار میلیارد حالت و صد کلید عددی ۳۱ رقمی. در ریاضیات به این افزایش سریع، رشد نمایی میگویند و آن را با فرمول ۲ به توان n نشان میدهند؛ جایی که n تعداد کلیدهاست.
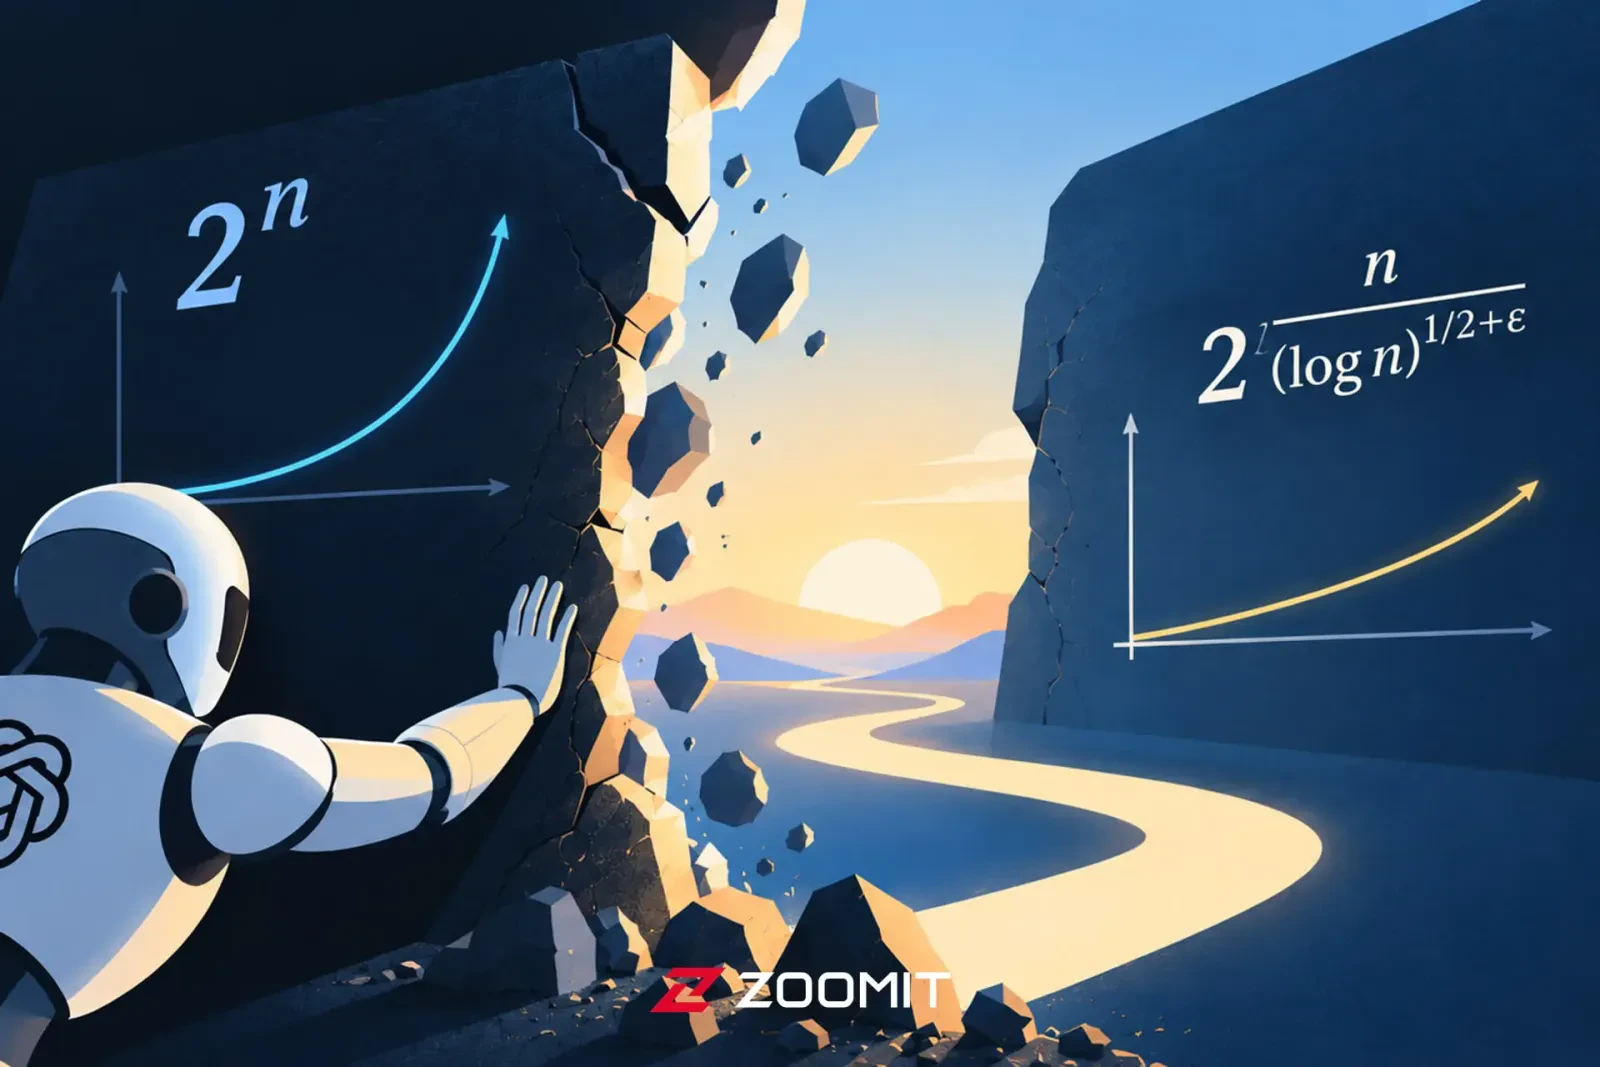
فرضیهی ETH میگفت هیچ الگوریتمی نمیتواند رشد نمایی زمان حل مسئلهی 3-SAT را بهکلی از میان بردارد
البته الگوریتمهای پیشرفته برای پیداکردن پاسخ، همهی حالتها را یکییکی امتحان نمیکنند و با حذف هوشمندانهی گزینههای بیفایده، تعداد حالتهایی را که باید بررسی شوند بهشدت کاهش میدهند. بهترین روشهای شناختهشده بهجای زمانی در حدود (2ⁿ)، در زمانی حدود (1.3ⁿ) به پاسخ میرسند؛ اما (1.3ⁿ) هم رشد نمایی دارد؛ هرچند پایهی توان کوچکتر شده است، ولی بازهم با افزایش تعداد کلیدها، زمان محاسبه همچنان با سرعتی صعودی، بالا میرود.
اواخر دههی ۱۹۹۰، ایمپالیاجو و پاتوری فرضیهای مطرح کردند که میگفت شاید نتوان هرگز از رشد نمایی زمان محاسبه گریخت. این حدس علمی که فرضیهی زمان نمایی یا ETH نام گرفت، میگوید هیچ الگوریتمی نمیتواند مسئلهی 3-SAT را در همهی موارد با زمانی کمتر از رشد نمایی حل کند؛ بهبیان سادهتر، شاید بتوان پایهی توان را از ۲ به عددی کوچکتر کاهش داد؛ اما نمیتوان رشد نمایی را بهکلی از میان برد.
کپی لینکمرز باریک میان نمایی و زیرنمایی
برای بررسی ETH و استدلالی که خلافش را ثابت میکند، باید تمایزی ظریف را جدی بگیریم. فرض کنید الگوریتمی پیدا شود که بهجای زمان 2ⁿ، مسئله را در زمان ⁽ⁿ/¹⁰⁰⁰⁾2 حل کند. چنین پیشرفتی از نظر عملی فوقالعاده خواهد بود؛ اما همچنان فرضیهی ETH را نقض نمیکند؛ چون توان همچنان کسری ثابت از n باقی میماند و با بزرگشدن مسئله، همپای n رشد میکند. درواقع زمان محاسبه همچنان بهصورت نمایی افزایش مییابد، هرچند کندتر.
حالا فرض کنید الگوریتمی پیدا شود که با بزرگترشدن مسئله، زمان محاسبهاش بسیار کندتر از چیزی افزایش یابد که ETH پیشبینی میکند؛ مثلا الگوریتمی توانش نه n/۱۰۰۰، بلکه n تقسیم بر ریشهی دوم لگاریتم n باشد. مخرج این کسر خیلی آرام بزرگ میشود؛ برای مسئلهای با یک میلیون متغیر، فقط به حدود ۳٫۷ میرسد. ریاضیدانها به این نوع رشد، زیرنمایی میگویند.
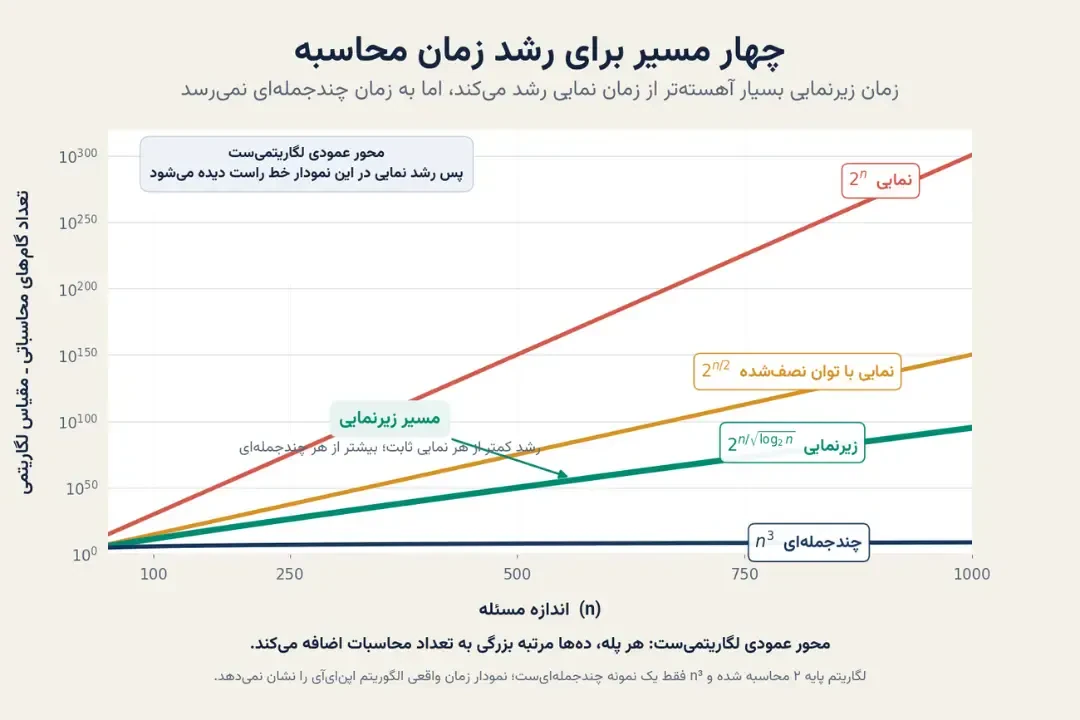
در روش قبلی، زمان محاسبه همچنان با آهنگ نمایی افزایش مییافت؛ اما در روش جدید، هرچه مسئله بزرگتر شود، زمان محاسبه در مقایسه با روشهای نمایی، بسیار کندتر افزایش مییابد، یا فاصلهاش از رشد نمایی معمول بیشتر و بیشتر میشود؛ درست همان چیزی که فرضیهی ETH امکان آن را برای حل 3-SAT رد میکند.
الگوریتم جدید رشد زمان محاسبه را از نمایی به زیرنمایی کاهش میدهد؛ همان چیزی که ETH ناممکن میدانست
فرضیهی ETH میگفت چنین الگوریتمی برای حل 3-SAT وجود ندارد؛ پس برای رد کردن فرضیه لازم نیست کسی 3-SAT را در چند ثانیه حل کند؛ کافیست الگوریتمی پیدا کند که زمان محاسبهاش از نوع زیرنمایی باشد و مخرج توانش، هرچند کند، بیوقفه رشد کند. اوپنایآی دقیقا از دستیافتن به چنین روشی خبر میدهد.
به گفتهی رایان ویلیامز، یکی از داوران پژوهش، الگوریتم جدید زمان محاسبه را به حدود ۲ به توان n تقسیم بر لگاریتم n به توان اندکی بیشتر از یکدوم کاهش میدهد؛ بنابراین الگوریتم با بزرگترشدن مسئله، از رشد نمایی موردانتظار ETH فاصله میگیرد؛ هرچند ممکن است حل مسائل بسیار بزرگ همچنان زمان فوقالعاده زیادی ببرد.
کپی لینکهوش مصنوعی بهجای پیداکردن یک جواب، همه را شمرد
بخش جالب برهانی که اوپنایآی برای رد فرضیهی ETH معرفی میکند، به شیوهی حل مسئله برمیگردد؛ زیرا الگوریتم صرفا بررسی نمیکند که آیا میتوان کلیدها را طوری تنظیم کرد که همهی شرطها برقرار شوند یا نه؛ بلکه تعداد دقیق چیدمانهای درست را هم محاسبه میکند. طبیعتا شمردن تمام پاسخهای درست، از یافتن یک پاسخ دشوارتر خواهد بود.
ریاضیدانان نسخهی شمارشی مسئله را #SAT مینامند؛ البته اگر تعداد پاسخهای درست را بدانیم، پاسخ پرسش سادهتر هم روشن میشود. اگر تعداد صفر باشد، هیچ راهحلی وجود ندارد؛ اما اگر بیشتر از صفر باشد، یعنی دستکم یک راهحل داریم؛ بدینترتیب، اوپنایآی برای پاسخدادن به پرسشی سادهتر، الگوریتمی معرفی میکند که از عهدهی مسئلهای دشوارتر هم برمیآید.
الگوریتم اوپنایآی تعداد تمام پاسخهای درست را محاسبه میکند
ایدهی کلی را میتوانید اینطور در نظر بگیرید که پژوهش ابتدا هر شرط منطقی را به عبارتی ریاضی تبدیل میکند که برای یک ترکیب سازگار، مقدار یک و برای ترکیب ناسازگار، مقدار صفر میگیرد. اگر عبارتهای همهی شرطها را در هم ضرب کنیم، پاسخهایی که حتی یکی از شرطها را نقض میکنند، حذف میشوند. جمع نتیجه روی تمام ترکیبها، تعداد پاسخهای معتبر را میدهد.
الگوریتم قطعی کار میکند، یعنی به انتخاب تصادفی متکی نیست و باوجود زمان اجرای طولانی، حافظهای بیشاز چندجملهای مصرف نمیکند. مقالهای ۶۷ صفحهای که همراه اعلامیهی اوپنایآی منتشر شد، ایده را در چند گام توضیح میدهد.
گام اول به یک مشاهدهی ساده برمیگردد. اگر بتوان کلیدها را به گروههای کوچکی تقسیم کرد که هیچ شرطی میانشان پل نزند، تعداد کل جوابها برابر حاصلضرب تعداد جوابهای هر گروه میشود. شمردن ده گروه دهتایی بهجای یک گروه صدتایی، کار را از عددی ۳۱ رقمی به حدود دههزار حالت میرساند.
اما مسئلههای واقعی هرگز اینقدر مرتب از هم جدا و تقسیم نمیشوند و نمیتوان جوابهای هر گروه را مستقل از بقیه شمرد. الگوریتم اوپنایآی برای حل مشکل، بهجای جداکردن مستقیم گروهها، شکل مسئله را با یک پارامتر کمکی تغییر میدهد. در این نسخهها، ارتباط میان گروهها به چند مقدار مشترک محدود میشود. وقتی مقدارها را مشخص کنیم، میتوانیم جوابهای هر گروه را جداگانه بشماریم. سپس الگوریتم با استفاده از نتایج شمارشها، تعداد جوابهای مسئلهی اصلی را بهدست میآورد.
الگوریتم قطعی کار میکند و به انتخاب تصادفی متکی نیست
در گام آخر، الگوریتم باید از جواب مسئلههای سادهتر به جواب مسئلهی اصلی برسد. اینجا یک ویژگی ریاضی به کمکش میآید، تعداد جوابها در نسخههای تغییریافتهی مسئله، از رابطهای مشخص پیروی میکند که ریاضیدانان آن را چندجملهای مینامند.
اگر مقدار رابطه را در چند نقطهی مناسب بدانیم، میتوانیم مقدارش را در نقطهای دیگر هم دقیقا محاسبه کنیم؛ حتی اگر محاسبهی مستقیم در آن نقطه بسیار دشوار باشد. الگوریتم از همین ویژگی استفاده میکند تا با کنار هم گذاشتن نتایج محاسبات آسانتر، تعداد جوابهای مسئلهی اصلی را بهدست آورد؛ درست مثلاینکه ارتفاع قلهای دستنیافتنی را از روی چند نقطهی دامنه و شکل دقیق منحنی آن بهدست آوریم.
روش جدید اوپنایآی بر شانهی ایدههای انسانی میایستد. پژوهشگران علوم کامپیوتر طی دو دههی گذشته ابزارهای مختلفی برای سادهکردن مسائل پیچیده ساختهاند.
الگوریتم «تقسیم و فهرست» رایان ویلیامز در سال ۲۰۰۵، روشهای جبری آندرئاس بیورکلوند و پژوهشهای مربوط به کدهای مبتنی بر گرافهای انبساطی، از جمله ایدههایی هستند که مقالهی اوپنایآی بر آنها تکیه میکند. لم پراکندهسازی ایمپالیاجو، پاتوری و زین نیز از دیگر مبانی نظری این پژوهش به شمار میرود.
کپی لینکبا فرو ریختن فرضیه سرنوشت مقالههای پیشین چه میشود؟
ETH در ربع قرن گذشته نقش ابزاری مشترک را بازی میکرد. دانشمندان معمولا نمیتوانند ثابت کنند الگوریتم سریعتری برای یک مسئله وجود ندارد؛ ولی با فرض ETH میتوانستند بگویند «اگر این مسئله سریعتر حل شود، 3-SAT هم سریعتر حل میشود و ETH میگوید چنین چیزی ممکن نیست». به گفتهی اوپنایآی، صدها مقاله در نظریهی گراف، زیستشناسی محاسباتی، پایگاههای داده و هندسهی محاسباتی با همین منطق نتیجه گرفته بودند.
اگر ادعا درست باشد، دامنهی لرزه از ETH فراتر میرود. مقالهی OpenAI صراحتا میگوید نتیجهی این برهان نسخهی قویتر، یعنی فرضیهی زمان نمایی قوی یا SETH و چند خویشاوند دیگرش را هم رد میکند.
SETH پایهی حوزهای بهنام پیچیدگی ریزدانه بود و برای مسائلی کاملا روزمره کران تعیین میکرد؛ مثلا اینکه فاصلهی ویرایشی، یعنی سنجش شباهت دو رشتهی DNA یا دو متن، احتمالا خیلی سریعتر از الگوریتمهای امروزی محاسبهشدنی نیست.
رد ETH صدها مقالهی علمی را خودبهخود باطل نمیکند، اما اعتبار برخی از نتایج آنها را زیر سوال میبرد
خود الگوریتم هم پیامدهای مستقیم دیگری دارد. به ادعای مقاله، شمردن رنگآمیزیهای مجاز یک نقشه، یعنی رنگکردن شهرها طوری که هیچ دو شهر همسایه همرنگ نباشند، یا شمردن جورسازیهای کامل در یک شبکه، حالا در زمان زیرنمایی ممکن میشود.
تصور کنید پژوهشگری ثابت کرده باشد: «اگر عبور از جادهی اول دستکم ده ساعت طول بکشد، رسیدن به شهر دوم هم کمتر از ده ساعت ممکن نیست». حالا معلوم میشود جادهی اول میانبری داشته است. کشف میانبر ثابت نمیکند مسیر شهر دوم هم کوتاه شود؛ فقط تضمین قبلی را از اعتبار میاندازد.
رد فرضیهی ETH هم دقیقا تاثیر مشابهی خواهد داشت. گزارههای شرطی مقالههای قبلی همچنان از نظر منطقی درست باقی میمانند؛ اما شرطشان دیگر برقرار نیست. مقالهی OpenAI هم یادآوری میکند که بخشی از کرانها از فرضیههای ضعیفتری مانند حدس بردارهای متعامد نیز بهدست میآیند که شاید هنوز پابرجا باشند. پس بهجای فروریختن یکبارهی ساختمان، باید منتظر بازرسی تکتک ستونها ماند.
کپی لینکآیا به حل P در برابر NP نزدیک شدهایم؟
برهان جدید اوپنایآی، ناگزیر این سوال را پیش میکشد که آیا به حل یکی از مشهورترین معماهای حلنشدهی علوم کامپیوتر، یعنی P در برابر NP، نزدیک شدهایم؟
اگر با مفهوم P در برابر NP آشنا نیستید، معمایی را تصور کنید که پیداکردن جوابش فوقالعاده دشوار است؛ اما اگر کسی جواب درست را جلوی شما بگذارد، میتوانید خیلی سریع آن را بررسی کنید. مسئلهی SAT در همین گروه مسائل جای میگیرد. P در برابر NP میپرسد آیا هر مسئلهای که بتوان جوابش را سریع بررسی کرد، لزوما راهی هم برای سریع پیداکردن جواب دارد؟
ریاضیدانان و دانشمندان علوم کامپیوتر دهههاست در جستوجوی پاسخاند؛ اما الگوریتم جدید اوپنایآی هنوز معما را حل نمیکند. برای درک بهتر ماجرا، به این نکتهی ظریف توجه کنید که «سریعتر از آنچه تصور میکردیم» و «واقعا سریع» با هم متفاوتاند.
الگوریتم جدید در دستهی روشهای زیرنمایی قرار میگیرد؛ یعنی با بزرگتر شدن مسئله، زمان اجرای آن از روشهای نمایی معمول آهستهتر افزایش مییابد. بااینحال، هنوز با الگوریتمهای چندجملهای که معیار ریاضی حل سریع مسائل بهشمار میروند، فاصلهی زیادی دارد.
کشف یک راه سریعتر برای حل مسئله، لزوما به معنای یافتن راهی سریع برای حل همهی مسائل دشوار محاسباتی نیست
ازسویدیگر روش جدید، برای خانوادهی مشخصی از مسائل SAT کار میکند که در آن تعداد متغیرهای هر شرط از حد ثابتی فراتر نمیرود. شاید وسوسه شویم نتیجه بگیریم حالا میتوان هر مسئلهی دشوار دیگری را هم با همین سرعت حل کرد؛ اما ماجرا به این سادگی نیست. تبدیل یک مسئله به مسئلهی دیگر گاهی اندازهاش را چنان افزایش میدهد که تمام مزیت الگوریتم جدید از بین میرود. خود نویسندگان مقاله نیز به این محدودیت اشاره کردهاند.
بنابراین، فعلا قرار نیست رمزنگاریهای رایج ناگهان شکسته شوند، مسائل پیچیدهی صنعتی در چند ثانیه حل شوند یا نرمافزارهای روزمره جهش بزرگی در سرعت تجربه کنند. حتی صحت برهان نیز باید از بررسی دقیق جامعهی علمی بگذرد.
اهمیت دستاورد بالقوهی اوپنایآی را زمانی بهتر درک میکنیم که ببینیم فرضیهای که دههها یکی از مهمترین محدودیتهای محاسباتی را توضیح میداد، اکنون با یک برهان ریاضی به چالش کشیده میشود. در صورت تاییدشدن برهان، پژوهشگران باید دوباره بررسی کنند کدام محدودیتها واقعا اجتنابناپذیرند و کدامها فقط به این دلیل پابرجا ماندهاند که هنوز راه بهتری پیدا نکرده بودیم.
کپی لینکچه کسی ادعای OpenAI را داوری میکند؟
شرکتهای هوش مصنوعی وقتی مسائل سنگینی را اثبات میکنند، برای اطمینان از درستی نتایج سراغ دستیار اثبات Lean میروند و اوپنایآی نیز مانند اثباتهای قبلیاش در حوزهی ریاضی، پیش از هر چیز نتایجش را به زبان Lean صورتبندی کرد.
دستیار Lean هر گام و هر مرحله از گام استدلال را با قواعد منطقی سختگیرانه چک میکند و اجازه نمیدهد نتیجهای بدون پشتوانه از مراحل قبلی بهدست بیاید؛ بدینترتیب، احتمال پنهانماندن خطاهای منطقی بهشدت کاهش پیدا میکند.
پس از دستیار اثبات، متخصصان باید بررسی کنند تعریفهای واردشده به Lean همان مدل محاسباتی و همان ادعایی را بیان میکنند که ETH دربارهاش حرف میزند. اوپنایآی در مقالهاش نشان میدهد که مسئله را میتوان با سرعتی بیشتر از آنچه پیشتر تصور میشد حل کرد. هرچنددامنهی ثبتشده در Lean کران زیرنمایی ضعیفتری را پوشش میدهد که برای رد فرضیهی ETH کفایت میکند.
پس از دستیار Lean، متخصصان هم باید درستی ادعا و دامنهی نتیجه را بررسی کنند
اوپنایآی میگوید گروهی به رهبری سه دانشمند برجسته، ایمپالیاجو و پاتوری از دانشگاه کالیفرنیا در سندیگو و رایان ویلیامز از MIT نتیجهی اثبات را بررسی خواهند کرد. دو نفر اول از کسانی هستند که نزدیک به سه دهه پیش فرضیهی ETH را مطرح کردند و برعکس ویلیامز در سال ۲۰۱۶ نسخهی خاصی از SETH را رد کرده بود؛ یعنی واضعان فرضیه و یکی از قدیمیترین افرادی که آن را به چالش کشیدهاند؛ حالا پشت یک میز نشستهاند.
سه دانشمند در نامهای سرگشاده به جامعهی علمی تاکید کردهاند که مشارکتشان را نباید گواهی بر درستی ادعا دانست؛ به گفتهی آنها، چنین نتیجهی مهم و حساسی به بررسی دقیق و مستقل نیاز دارد. ویلیامز میگوید گروه هیچ قرارداد عدمافشایی امضا نکرده است و پولی هم دریافت نمیکند.
اوپنایآی به درخواست گروه، دادههای خام را منتشر کرد و متعهد شد هزینهی کنفرانسی دربارهی پیامدهای نتیجه را بپردازد. شرکت همچنین میگوید برای کشفهایی که مدلهای داخلیاش تولید میکنند، اعتبار علمی مطالبه نخواهد کرد؛ تصمیمی که دوباره این سوال را پیش میکشد که وقتی هوش مصنوعی به دستاوردی میرسد، اعتبار علمیاش به چه کسی میرسد؟
ازسویدیگر سابقهی شرکت اوپنایآی هم احتیاطهای فعلیاش را توجیه میکند. طبق فایل تاریخچهی مخزن ریاضی شرکت در گیتهاب، این شرکت ۷ اکتبر سه مقالهی تولیدشده توسط مدلهایش را بهدلیل یک خطای علامت پس گرفت و ۱۴ مقالهی دیگر را اصلاح کرد.
کپی لینکسه ادعای بزرگ در یک روز
شرکت اوپنایآی ۲۶ اکتبر علاوه بر ETH، از دو دستاورد احتمالی دیگر نیز خبر داد. نخست برهانی برای حدس «هموارسازی محلی» در همهی ابعاد و دوم دستاوردی در حوزهی فیزیک، یعنی اثبات وجود ریاضی نظریهی کرومودینامیک کوانتومی؛ کاری که بخشی از مسئلهی یانگ-میلز، یکی از مسائل جایزهی هزاره را در بر میگیرد.
گروهی از فیزیکدانان به سرپرستی دیوید گراس، برندهی نوبل فیزیک، تصمیم گرفتهاند فعلا متن تولیدشده توسط هوش مصنوعی را منتشر نکنند. آنها میخواهند ابتدا خودشان برهان را بررسی کنند و توضیحی علمی و قابلفهم از آن بنویسند. به این ترتیب، برخلاف ETH، پژوهشگران دیگر هنوز به متن اصلی برهان فیزیک دسترسی ندارند.
تصمیم گروه گراس با مخالفتهایی نیز مواجه شد، بهطور خاص، گروهی مستقل از ۹ ریاضیدان برجسته، از جمله تیموتی گاورز و ادوارد ویتن، در بیانیهای به تاریخ ۲۶ اکتبر خواستار انتشار فوری برهانهای مربوط به فیزیک شدند. آنها استدلال میکنند که وقتی بررسی کامپیوتری برهان به پایان میرسد، دیگر دلیل علمی برای پنهان نگهداشتنش وجود ندارد.
بیش از ۲۵ سال پیش، فرضیهی ETH به دانشمندان کمک کرد محدودیتهای حل مسائل پیچیده را بهتر بشناسند. حالا دو نفر از کسانی که این فرضیه را مطرح کردند، خودشان در بررسی ادعای رد آن مشارکت دارند. اگر نتیجه تایید شود، بدین معنا نیست که کامپیوترهای ما ناگهان سریعتر میشوند؛ بلکه نشان میدهد دستکم یکی از محدودیتهایی که سالها قطعی تصور میکردیم، آنقدرها هم دستنیافتنی نبوده است.